MiniMax hat MiniMax M3.1 Flash am 19. Oktober 2026 mit einem Listenpreis von 0,15 Dollar pro Million Eingabe-Token und 0,60 Dollar pro Million Ausgabe-Token veröffentlicht. Das Modell ist über die firmeneigenen Dienste verfügbar, während die Modellgewichte zu einem späteren Zeitpunkt folgen sollen. Für Entwickler von Agenten und Software ist die Preissenkung relevant, doch der Preis eines einzelnen Token bestimmt nicht allein die Kosten eines Aufgabenprozesses: Letztere hängen auch davon ab, wie viel das System schlussfolgert, welche Werkzeuge es einsetzt und wie viele Korrekturen nötig sind.
Der Listenpreis halbiert zwei Tarife, nicht jede Rechnung
Die offizielle Preisseite erlaubt einen genauen Vergleich. Im Standardbereich bis 512.000 Eingabe-Token kostet MiniMax M3 laut Herstellerangaben 0,30 Dollar pro Million Eingabe-Token und 1,20 Dollar pro Million Ausgabe-Token. Flash halbiert beide Tarife. Die Cache-Leserate sinkt von 0,06 auf 0,015 Dollar pro Million Token. Das sind unterschiedliche Abrechnungsposten: Der Cache-Preis gilt nur für Token, die tatsächlich als wiederverwendbar erkannt werden, nicht für das gesamte gesendete Material.
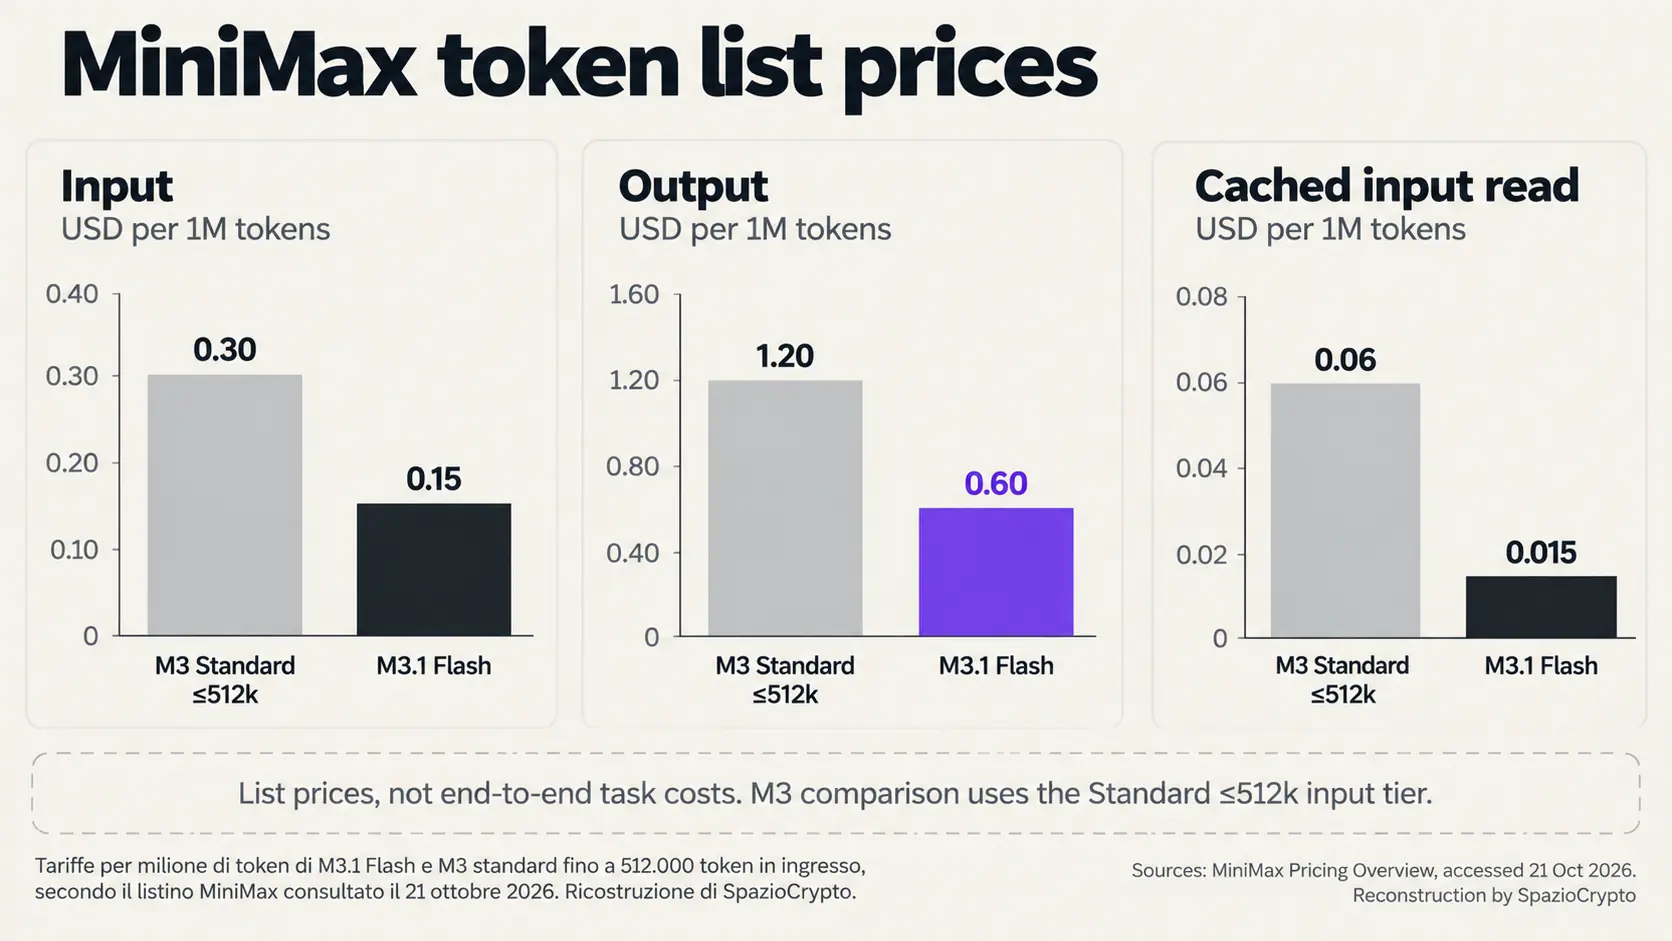
Laut MiniMax-Pressemitteilung liegen die Gesamtkosten agentischer Aufgaben um 70 % niedriger als beim Vorgänger. Dieser Wert deckt sich nicht mit der Halbierung der zwei Haupttarife. Er kann Unterschiede im Verbrauch und in der Ausführungsweise einschließen, rechtfertigt aber keine pauschale Einsparzusage an jeden Kunden. Für alle, die automatisierte Systeme einsetzen, trennt diese Unterscheidung einen nachprüfbaren Listenpreis von einem operativen Ergebnis, das erst auf der eigenen Arbeitslast gemessen werden muss.
Ein Rechenbeispiel verdeutlicht den Unterschied. Eine Million Eingabe-Token innerhalb der angegebenen Preisstufe und 100.000 Ausgabe-Token ohne Cache würden mit Flash 0,21 Dollar kosten, mit M3 in der gleichen Stufe 0,42 Dollar. Das ist eine eigene, indikative Berechnung auf Basis desselben hypothetischen Verbrauchs. Sie enthält keine zusätzlichen API-Aufrufe, Werkzeuge oder manuellen Eingriffe. Wiederholt ein Agent einen Schritt oder erzeugt mehr Schlussfolgerungsschritte, ändert sich die abgerechnete Menge, selbst wenn der Einheitspreis gleich bleibt.
Reasoning hat eine Regulierung, keine Abschaltung
Die Dokumentation der Anthropic-kompatiblen Schnittstelle beschreibt fünf Reasoning-Stufen, von „low“ bis „max“. Bei M3.1 Flash ist „max“ der Standardwert, wenn der Parameter weggelassen wird. Adaptives Reasoning lässt sich mit den zum Deaktivieren gedachten Werten nicht abschalten: Die Dokumentation meldet für diese Anfrage einen Fehler. Wer frühere Konfigurationen wiederverwendet, muss daher das tatsächlich unterstützte Verhalten des neuen Modells prüfen.
Laut derselben Dokumentation kann eine höhere Stufe mehr Reasoning-Token und größere Latenz erzeugen. Der Preis pro Token und die Gesamtdauer der Antwort beschreiben damit zwei verschiedene Aspekte. Eine sinnvolle Evaluierung sollte Ziel, Werkzeuge und Akzeptanzkriterien konstant halten und die gewählte Stufe notieren. Andernfalls vergleicht man eine schnelle Antwort mit gründlicherer Arbeit, ohne den Grund für den Unterschied offenzulegen.
MiniMax M3.1 Flash: Space Performance + Bunny Speed 🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash. 💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed. API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens. Model weights will arrive on Oct 23. API: https://t.co/fHRdSV73Hr M Plan: https://t.co/XfJWSyauda MiniMax Code for desktop: https://t.co/SGmLTI2HQm
, MiniMax (official) (@MiniMax_AI) October 19, 2026
Der offizielle Katalog nennt ein Kontextfenster von einer Million Token und multimodale Fähigkeiten. Die angegebene Kapazität ist keine Garantie dafür, dass jedes lange Dokument korrekt verarbeitet wird. Wer das Modell über eine API-Schnittstelle einbindet, muss sicherstellen, dass notwendige Informationen zwischen den einzelnen Schritten erhalten bleiben. Eine sehr umfangreiche Anfrage kann überflüssige oder widersprüchliche Anweisungen enthalten: dass das Modell sie annimmt, beweist nicht, dass es stets das richtige Material auswählt.
Benchmarks bleiben begrenzte Einzeltests
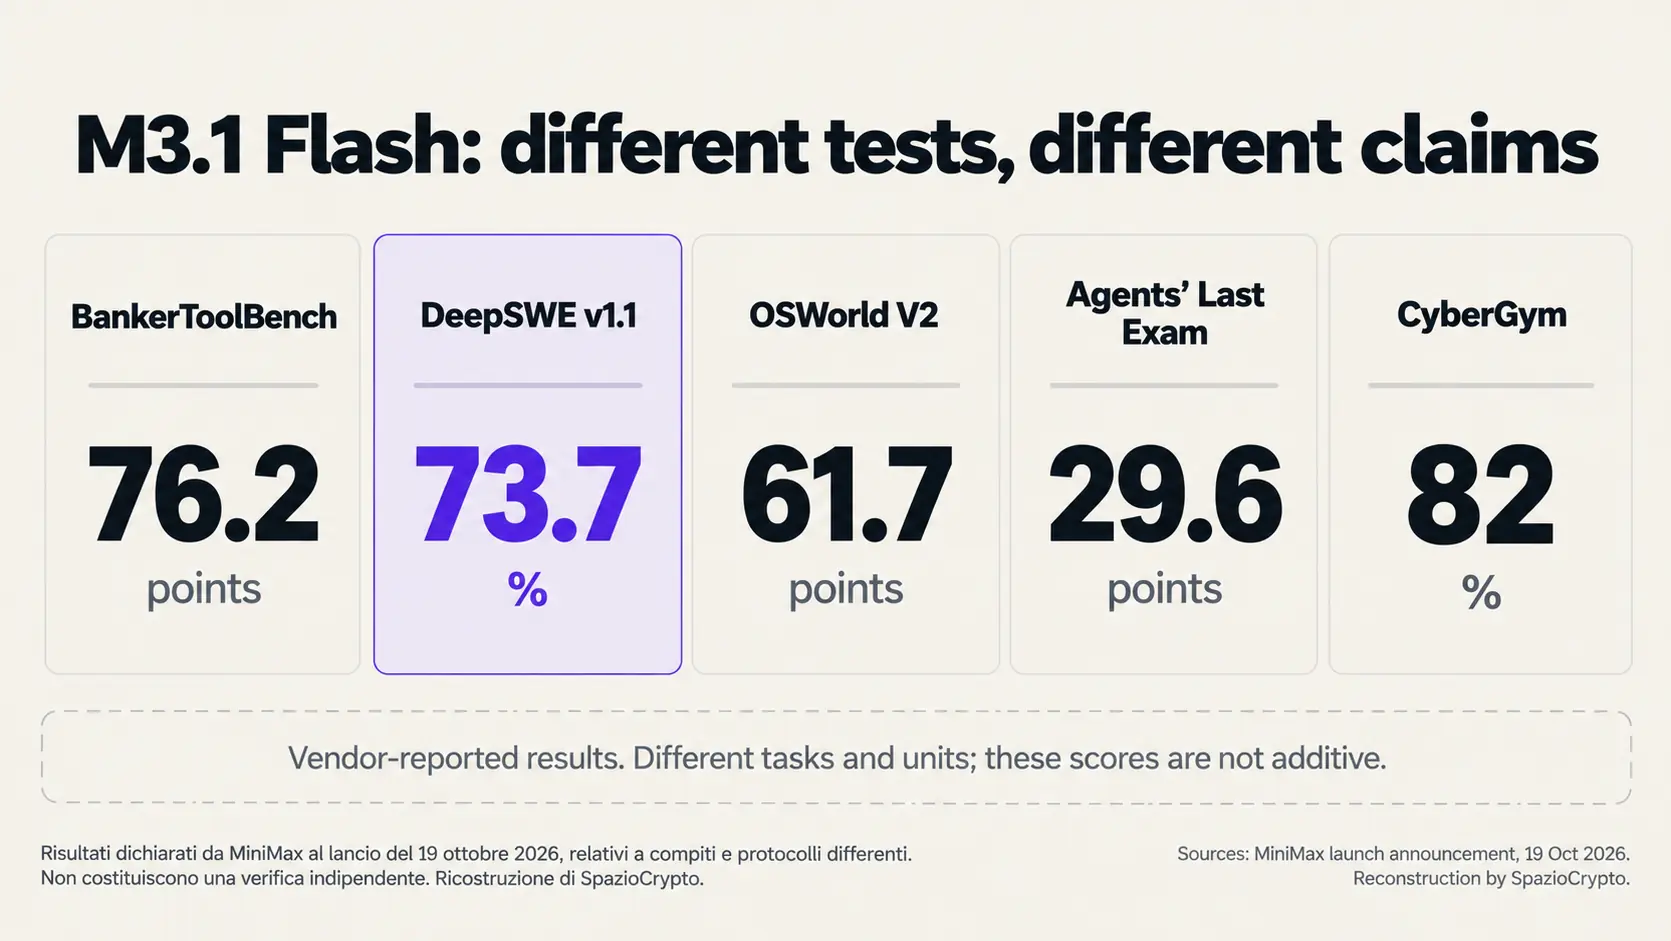
MiniMax veröffentlicht Ergebnisse zu Programmierung, Computerbedienung und Sicherheit. Laut Pressemitteilung des Herstellers erreicht das Modell 73,7 % auf DeepSWE v1.1, 61,7 Punkte auf OSWorld V2 und 82 % auf CyberGym. Die Mitteilung nennt außerdem 76,2 Punkte auf BankerToolBench und 29,6 auf Agents' Last Exam. Die Tests erfassen unterschiedliche Aufgaben und lassen sich nicht addieren, um eine allgemeine Zuverlässigkeitsquote zu bilden. Ein gutes Ergebnis bei Coding-Problemen belegt nicht, dass ein Agent Dokumente oder Finanzgenehmigungen fehlerfrei bearbeitet.
Auch Geschwindigkeitsangaben brauchen ein Etikett. Laut Herstellerangaben erreicht das Modell unter bestimmten Bedingungen über 200 Token pro Sekunde, der Median liegt über 170. Das sind Werte der eigenen Infrastruktur, keine Garantie für die Zeit, die jede Prozedur tatsächlich benötigt. Die Anzahl generierter Token pro Sekunde schließt nicht automatisch alle Wartezeiten zwischen API-Aufrufen, Antworten externer Dienste und manuelle Überprüfungen ein.
Diese Unterscheidung gilt auch beim Vergleich von Modell-Benchmarks. Eine Zahl muss von der Testversion, den erlaubten Werkzeugen und der Reasoning-Konfiguration begleitet werden. Für Flash sind Vergleiche mit identischem Ziel und einem deklarierten Budget sinnvoll. Eine Fähigkeit, Sicherheitslücken zu finden, als allgemeinen Zuverlässigkeitsbeweis zu präsentieren, würde die beobachtete Aufgabe mit allen anderen möglichen Tätigkeiten des Modells verwechseln.
Artificial Analysis liefert eine externe Einschätzung anhand einer anderen Testsuite: In einem dedizierten Beitrag auf X weist das Unternehmen Flash 42 Punkte im Intelligence Index zu, bei maximalem Reasoning. Laut diesem Beitrag kostet eine Index-Aufgabe mit Flash rund 0,22 Dollar, gegenüber rund 0,51 Dollar für M3. Das ist eine Bewertung eines vom Hersteller unabhängigen Dritten. Dieser Kostenwert bezieht sich auf die Aufgaben und die Methodik des Indexes, nicht auf den universellen Preis jeder beliebigen Arbeit, die dem Modell übertragen wird.
Dienstzugang und Gewichtskontrolle sind verschiedene Phasen
Die Veröffentlichung vom 19. Oktober nennt drei Zugangswege: MiniMax-API, M Plan und MiniMax Code. Die Pressemitteilung verweist die Gewichte auf einen späteren Zeitpunkt ohne konkretes Datum; ein Beitrag auf der offiziellen MiniMax-LinkedIn-Seite nennt hingegen den 23. Oktober. Das ist ein angekündigter Termin, keine bereits erfolgte Veröffentlichung. Der nutzbare Dienst und das herunterladbare Artefakt sind damit zwei verschiedene Phasen. Die Identifikation von Space Bunny als frühere Version des Modells ist eine Aussage von MiniMax; der anonyme Name stellt keine unabhängige Bewertung dar.
MiniMax-M3.1-Flash scores 42 on the Artificial Analysis Intelligence Index, 13 points higher than MiniMax-M3 and less than half the cost per task. It scores level with GLM-5.3-Flash but behind DeepSeek V4.1 Flash 1017
, Artificial Analysis (@ArtificialAnlys) October 19, 2026
MiniMax-M3.1-Flash is @MiniMax_AI's new Flash reasoning… pic.twitter.com/bEelNegMKP
Die zwei Modalitäten ermöglichen unterschiedliche Überprüfungen. Ein gehosteter Dienst erlaubt es, Schnittstelle und Antwortverhalten sofort zu testen. Die Veröffentlichung der Gewichte würde ermöglichen, das Artefakt zu archivieren und andere Konfigurationen zu erforschen, abhängig von der begleitenden Lizenz. Die Pressemitteilung beschreibt diese Lizenz nicht und nennt auch die erforderliche Hardware nicht. Bis zur Veröffentlichung wäre es verfrüht, Flash bereits eine vollständige eigenständige Verfügbarkeit zuzuschreiben.
Die nützliche Rechnung ist die der abgeschlossenen Aufgabe
Konkret: beim Übergang vom assistierten zum agentischen Coding verteilen sich die Kosten auf mehrere Versuche. Ein Agent kann ein Repository lesen, eine Änderung vorschlagen, Tests ausführen und auf den Code zurückkommen, wenn eine Prüfung scheitert. Das ist ein eigenes operatives Beispiel, kein gemessenes Ergebnis auf Flash. Der wirtschaftliche Vergleich sollte die gesamte Sequenz bis zur Abnahme der Arbeit zählen, einschließlich der Ausführungen, die keine verwendbare Lösung liefern.
Der Wert einer unabhängigen Bewertung hängt auch davon ab, wie gut diese Sequenzen beobachtbar und reproduzierbar sind. Empfehlenswert ist es, Ergebnis, Verbrauch, Wiederholungen und Korrekturen zu protokollieren und dabei das Akzeptanzkriterium konstant zu halten. Eine niedrigere Reasoning-Stufe kann eine einzelne Wartezeit verkürzen und spätere Überarbeitungen erhöhen. Das ist eine Hypothese, die auf der gewählten Arbeitslast zu prüfen ist, kein Verhalten, das dem Modell ohne Messung zugeschrieben wird.
MiniMax M3.1 Flash: Zusammenfassung
- Bestätigt: Veröffentlichung am 19. Oktober, öffentlicher Listenpreis und Dokumentation des gehosteten Zugangs.
- Noch nicht verifiziert: tatsächliche Veröffentlichung der auf LinkedIn für den 23. Oktober angekündigten Gewichte und Einsparungen bei jedem Prozess.
- Zu beobachten: Verbrauch bei gleicher Aufgabe, erforderliche Korrekturen und Verfügbarkeit der angekündigten Artefakte.
Der größere Zusammenhang
Der Wettbewerb im Bereich angewandter künstlicher Intelligenz verlagert sich vom Preis der Antwort zu den Kosten akzeptabler Arbeit. Der Listenpreis von Flash senkt eine messbare Komponente, beseitigt aber nicht die Notwendigkeit, das Ergebnis zu prüfen. Ein günstiges Modell wird nützlich, wenn es bei gleichem gefordertem Ergebnis und gleichen Ausführungsbedingungen auch die Schritte reduziert, die Korrekturen erfordern.
Die nächsten konkreten Signale werden sein: die Einhaltung des angekündigten Termins für die Gewichte, reproduzierbare Vergleiche mit expliziten Konfigurationen und Messungen auf repräsentativen Aufgaben. Zu beobachten ist auch, was passiert, wenn das System scheitert: ob es die Grenze meldet, die Arbeit abbricht oder weiter Kosten verursacht. Das sind Unterschiede, die ein Tarif pro Million Token nicht beschreiben kann, die aber die Endkosten eines zuverlässigen Agenten bestimmen.