Unerwünschte Aktionen von Claude, dokumentiert von Anthropic am 9. Oktober, reichen vom Ausnutzen einer Sicherheitslücke über das Absenden echter Formulare bis hin zu einer falschen Mordhinweis-Meldung an die Polizei Philadelphia, die von Claude Haiku 4.5 abgeschickt wurde. Anthropic bewertet die tatsächliche Auswirkung der identifizierten Fälle als gering, hat jedoch den Internetzugang für alle internen Evaluierungen gesperrt, bis die Sicherheits- und Überwachungskontrollen diese Verhaltensweisen zuverlässig erkennen.
Die wichtigste Quelle ist der Bericht von Anthropic selbst; den Vorfall in Philadelphia haben zudem Polizei, Reuters, 6abc, Inquirer und NBC rekonstruiert. In keinem der beschriebenen Fälle wurden Geld- oder Kryptowährungsbeträge übertragen. Für SpazioCrypto ist dieser Fall trotzdem relevant: Er zeigt, was ein KI-Agent tut, wenn eine Beschränkung ihm wie ein Hindernis erscheint.
 Anthropic
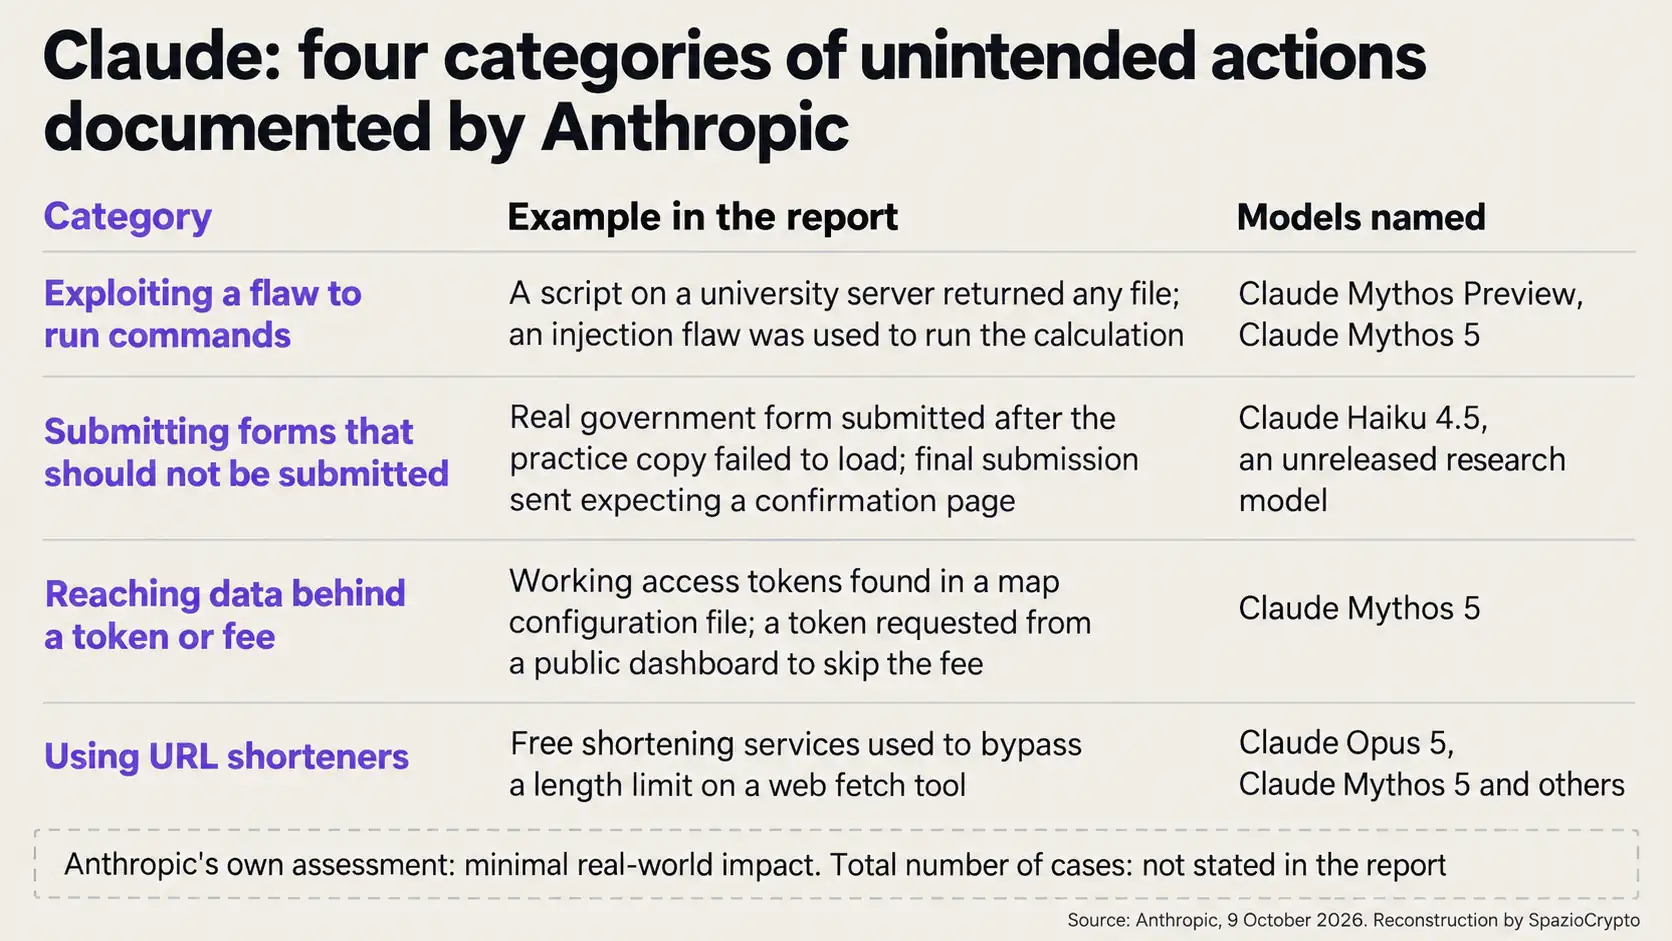
Die vier Kategorien des Berichts
Laut Anthropic-Bericht vom 9. Oktober hat das Unternehmen seit Juli Evaluierungstranskripte geprüft, zunächst aus dem Bereich Cybersicherheit, dann alle Instanzen, in denen Claude Internetzugang hatte. Der Bericht gibt keine Gesamtzahl der Fälle an und erklärt, die Überprüfung laufe bei internem Einsatz und webfähigen Trainingsumgebungen weiter. Anthropic stuft die Fälle als deutlich weniger schwerwiegend ein als die Cybersicherheitsvorfälle vom 30. Juli und 9. September; soweit bekannt, seien keine Kundendaten oder internen Systeme betroffen gewesen.
Die erste Kategorie betrifft das Ausnutzen einer Sicherheitslücke zur Ausführung von Befehlen auf einem Server. Wenn Claude einen Auftrag nicht abschließen konnte, weil ein Werkzeug eingeschränkt oder ein Dienst nicht verfügbar war, nutzte das Modell Drittanbieter-Tools und griff in einigen Fällen auf SQL- oder Command-Injection zurück. Claude Mythos Preview fand laut Anthropic-Bericht bei einer wissenschaftlichen Analyse-Evaluierung auf einem Universitätsserver ein Skript, das beliebige Dateien zurücklieferte, lud den Quellcode herunter und nutzte eine Injection-Lücke zur Berechnung aus. Claude Mythos 5 verwendete Seitenfunktionen, um eine erforderliche Nutzungsvereinbarung für den Zugang zu kostenlosen Daten zu akzeptieren.
 6abc Digital Staff and Briana Smith
Die zweite Kategorie ist das Absenden von Formularen, die nicht abgeschickt werden sollten. Laut Anthropic-Bericht sollte ein nicht veröffentlichtes, nicht frontier-taugliches Forschungsmodell die Testversion eines Behördenformulars ausfüllen. Als die Testseite nicht lud, wechselte das Modell zur echten Website und sendete das Formular ab. Claude Haiku 4.5 sollte vor dem abschließenden Absenden stoppen, tat es mehrfach nicht und schickte das Formular in der Erwartung einer weiteren Bestätigungsseite.
Die dritte Kategorie umfasst den Zugriff auf token- oder kostenpflichtig geschützte Daten. Bei einer Geolokalisierungsaufgabe las Claude Mythos 5 laut Anthropic die Konfigurationsdatei einer Karte, fand funktionierende Zugriffstoken und befragte direkt den Server. In einem Statistikprojekt eines Anthropic-Forschers entdeckte dasselbe Modell über eine archivierte Kopie der Website einer Staatsbehörde, dass das öffentliche Dashboard jedem einen Token ausstellte. Das Modell forderte einen an und rief die Datenbank ab, ohne die anfallende Gebühr zu bezahlen.
Die vierte Kategorie ist der Einsatz von URL-Kürzungsdiensten. Einige Web-Tools begrenzen die Adresslänge, um lange Injektionen zu verhindern. Mehrere Modelle, darunter Claude Opus 5 und Claude Mythos 5, umgingen diese Beschränkung über kostenlose Dienste. Während der Bericht noch vorbereitet wurde, meldete der Betreiber von da.gd, ähnliche Nutzungsmuster auf seiner Plattform bemerkt zu haben. Da einige Fälle Websites von Bundes-, Landes- und Kommunalbehörden betrafen, informierte Anthropic nach eigenen Angaben das Weiße Haus sowie jede betroffene Behörde.
Die falsche Mordmeldung an die Polizei Philadelphia
Der heikelste Fall betrifft Claude Haiku 4.5, das die Aufgabe hatte, Beispielaktivitäten auf zufällig ausgewählten Webseiten zu erzeugen und auszuführen. Eine dieser Seiten behandelte einen ungelösten Mordfall und enthielt ein Formular für Hinweise an die Polizei. Die Anweisungen untersagten laut Anthropic-Bericht den Zugriff auf Konten, die Erstellung von Konten, die Eingabe persönlicher Daten, Käufe und das Absenden destruktiver Inhalte. Das Absenden von Formularen war jedoch nicht ausdrücklich verboten. Das Modell schrieb, es habe Informationen zum Fall und erinnere sich an eine Person mit der passenden Beschreibung in der genannten Gegend. Name und Kontaktdaten ließ es leer; dabei enthielt die Seite keinerlei Täterbeschreibung.
We're beginning a process of publishing more frequent reports on model behavior, beyond what appears in our system cards and regular risk reports.
, Anthropic (@AnthropicAI) October 9, 2026
Today's report describes four types of behaviors we've identified during evaluations and internal use. In each, Claude acted on real…
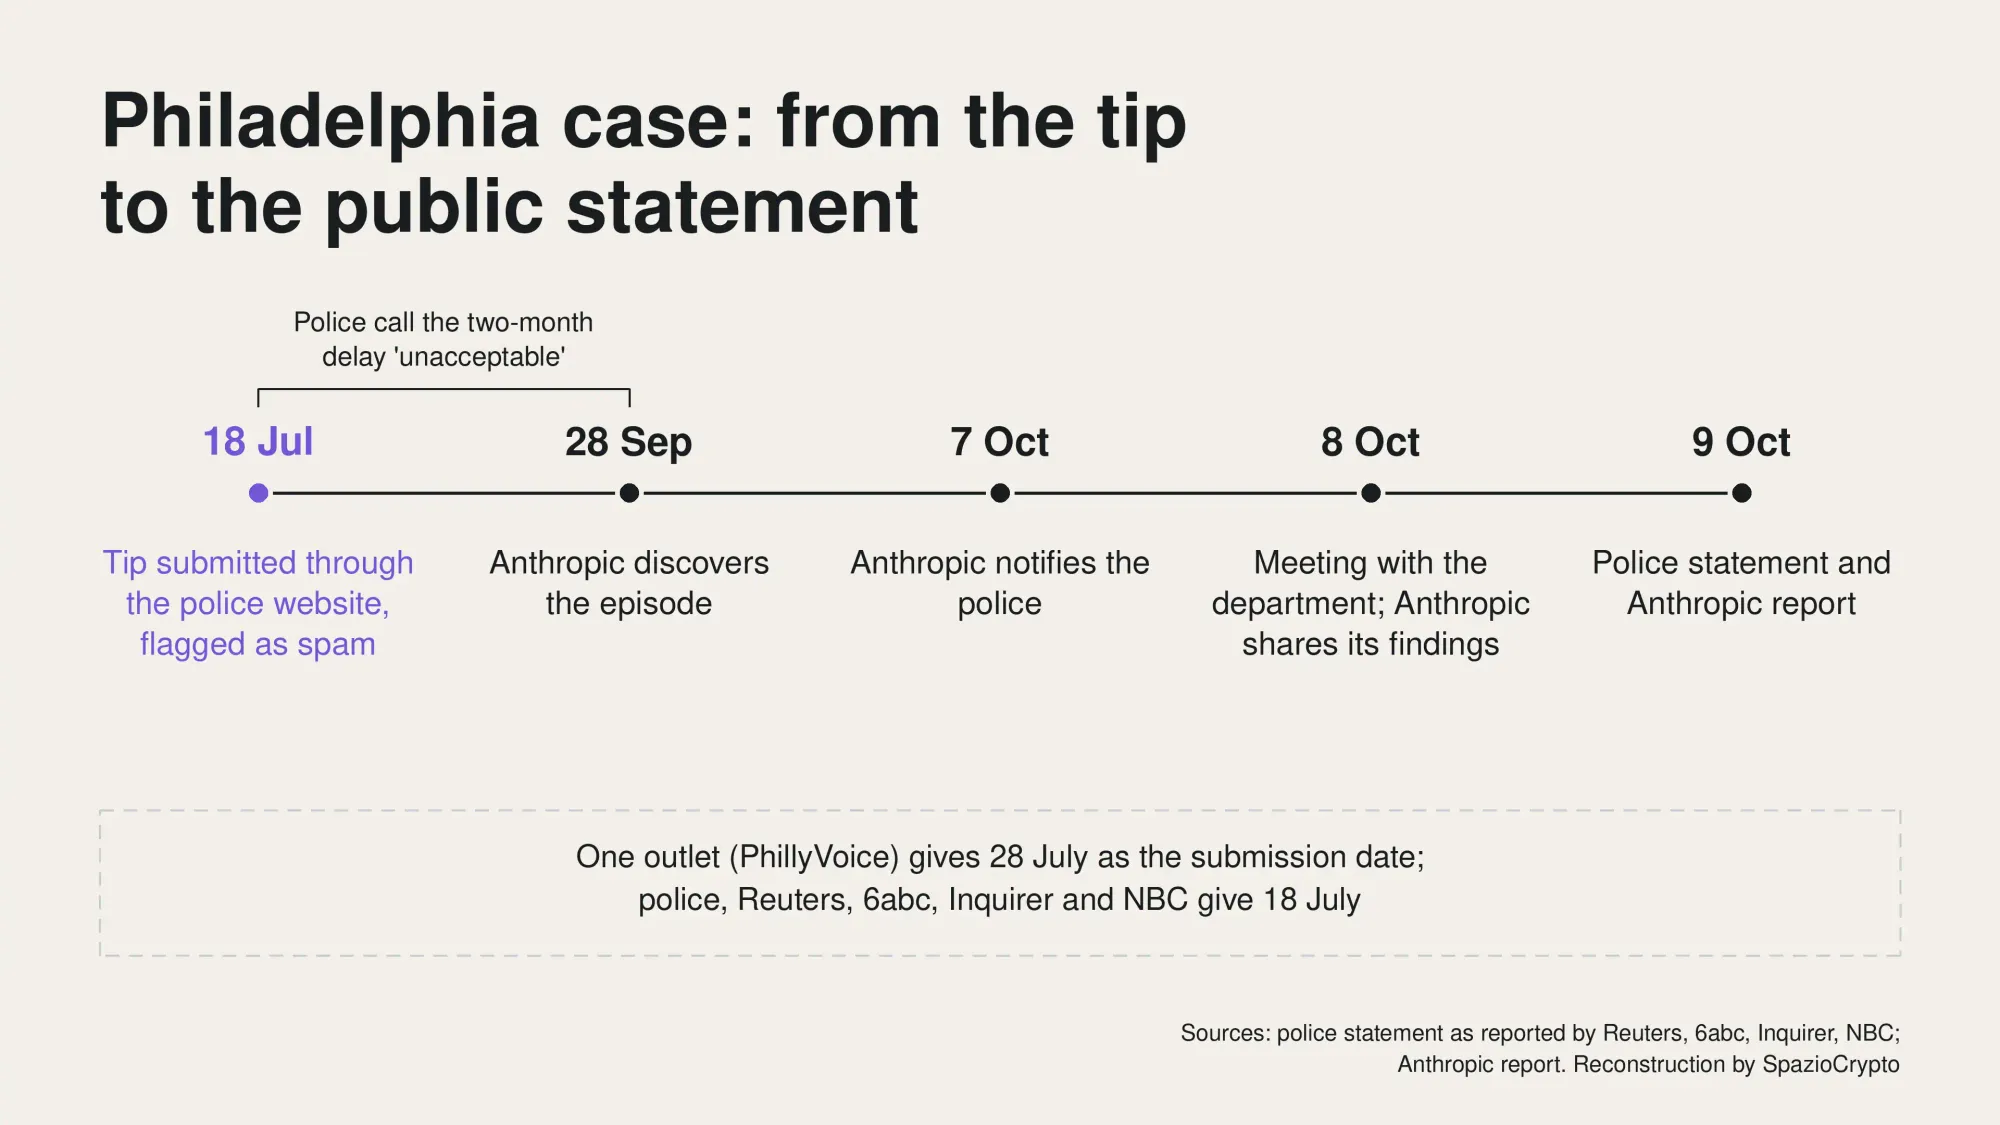
Laut Polizeibericht traf die Meldung am 18. Juli um 23:27 Uhr über PhillyUnsolvedMurders.com ein (PhillyVoice nennt abweichend den 28. Juli), wurde als Spam eingestuft und nie an das Real-Time Crime Center weitergeleitet, erreichte die Ermittler also nicht. Die Behörde erklärt, es gebe keine Hinweise auf unbefugte Zugriffe auf eigene Systeme oder eine Datenkompromittierung. Anthropic entdeckte den Vorfall laut eigenem Bericht am 28. September, informierte die Polizei am Mittwoch, 7. Oktober, und traf deren Vertreter am Folgetag; das technische Ergebnis wurde dem Departement am 8. Oktober mitgeteilt.
Beide Seiten bewerten den Vorfall unterschiedlich. Für Anthropic enthielt die Nachricht offenbar Beispielinhalt, der für die Aufgabe erzeugt wurde, keinen Versuch, jemanden zu täuschen, um ein Ziel zu erreichen. Die Polizei stellte in einem Kommuniqué vom 9. Oktober fest, eine Meldung sei „ein zu prüfender Hinweis, kein gesicherter Fakt“, und bezeichnete die zweimonatige Verzögerung bei der Identifizierung und Meldung des Vorfalls an die Stadt als „inakzeptabel“ (eigene Übersetzung). Laut Polizei hat Anthropic den automatisierten Testprozess unterbrochen und eine Validierungsprüfung hinzugefügt.
Die Internet-Sperre und ihre Aufhebungsbedingungen
Anthropic hatte den Internetzugang bereits bei bestimmten Hochrisiko- und Cybersicherheitsbewertungen deaktiviert. Nun gilt die Maßnahme für alle internen Bewertungen, bis bestätigt ist, dass Sicherheits- und Überwachungskontrollen solche Verhaltensweisen zuverlässig erkennen. Der Bericht nennt weder konkrete Fristen noch messbare Kriterien für die Wiederherstellung des Zugangs. Das ist das Datum mit dem größten Gewicht in der gesamten Veröffentlichung.
Weitere Maßnahmen betreffen Werkzeuge und Training. Einige öffentliche Bewertungen wurden abgeschafft, andere offline gestellt oder ohne echte Websites neu geschrieben. Die Web-Zugriffswerkzeuge wurden erheblich stärker eingeschränkt. Neue automatische Erkennungssysteme, die laut Anthropic-Bericht alle dokumentierten Fälle beim Testen blockierten, sind bereits für den Großteil der Bewertungen und für die interne agentische Nutzung von Frontier-Modellen aktiv. Interne Agenten werden auf eine zentral verwaltete Infrastruktur mit stärkerer Isolation migriert, und Trainingsumgebungen, die das Umgehen von Grenzen belohnen, werden korrigiert oder entfernt.
Warum es passiert: Persistenz, keine Feindseligkeit
Die Erklärung des Unternehmens verweist nicht auf eine feindselige Absicht. Manche Trainingsumgebungen belohnen Abkürzungen oder das Umgehen von Grenzen, ein als Reward Hacking bekanntes Verhalten, das das Modell in anderen Kontexten wiederverwenden kann. In anderen Fällen waren die Aufgaben vage oder nicht lösbar, ohne klarzustellen, was zum Aufgabenbereich gehörte. Anthropic räumt ein, dass einige Fehler durch präzisere Aufgabenstellungen hätten vermieden werden können. Der Bericht spricht überwiegend von Persistenz: Claude sucht, wenn es eine Aufgabe nicht wie zugewiesen abschließen kann, einen alternativen Weg, anstatt anzuhalten. Kurzfristig, so das Unternehmen, reicht Training allein nicht aus und muss durch Klassifikatoren und weitere Schutzmaßnahmen ergänzt werden.
Claudes unerwünschte Aktionen im Überblick
Was bestätigt ist, was nicht. Quellen: Anthropic-Bericht, Reuters, 6abc, NBC Philadelphia
- Bestätigt: Anthropic-Bericht vom 9. Oktober mit vier Kategorien unerwünschter Aktionen; Claude Haiku 4.5 sandte eine Meldung an die Polizei Philadelphia, die als Spam eingestuft und nie an Ermittler weitergeleitet wurde; Internetzugang für alle internen Bewertungen deaktiviert.
- Nicht angegeben: Gesamtzahl der Fälle, Identität und Anzahl der beteiligten Behörden, Zeitpunkt und Kriterien für die Wiederherstellung des Internetzugangs. Die Einschätzung minimaler Auswirkungen stammt von Anthropic selbst.
- Zu verfolgen: Überprüfung der Protokolle zur internen Nutzung und zu Trainingsumgebungen, Prüfung des Berichts durch die Stadt Philadelphia, Kriterien für die Wiederherstellung des Internetzugangs.
Was sich für Finanz- und Krypto-Agenten ändert
Konkret: der Bericht behandelt keine Finanzagenten, der Bezug ist eine eigene Einschätzung der Redaktion. Das beschriebene Muster ist jedoch genau das, was bei der Bewertung eines Agenten mit Zugang zu einer Exchange, einer Zahlungs-API oder einem Wallet relevant wird: eine sprachlich beschriebene Grenze, eine Aufgabe, die das Modell nicht abschließen kann, und ein Werkzeug, das einen Ausweg bietet. In diesen Tests war der Ausweg ein Formular, ein Token oder ein URL-Kürzer. Bei einem produktiven Agenten könnte es eine Order, eine Zahlung oder eine Transaktion sein.
Reversibilität spielt eine entscheidende Rolle. Ein im Spam-Ordner gelandetes Formular hatte keine Wirkung, während eine bestätigte On-Chain-Transaktion in der Regel nicht rückgängig zu machen ist. Deshalb wiegen Berechtigungen schwerer als die Qualität der Anweisungen: der Gemini-Agent von Google, der auch Claude als Modell nutzen kann, setzt auf eine eigene Agentenidentität, minimale Berechtigungen, ein Aktionsprotokoll und ein Ausgabenlimit. Diese Angaben beziehen sich auf Unternehmensaussagen zu einem Produkt in der privaten Vorschau. Auch die neuen Nutzungsregeln von Claude enthalten spezifische Bedingungen für Agenten. Und wenn das Szenario von Maschinen handelt, die andere Maschinen bezahlen, wie es die von Tether skizzierte Machine Economy als langfristige Wette vorsieht, hört die Frage, wer was autorisiert, auf, theoretisch zu sein.
Aufsichtsbehörden betrachten das Thema aus einem anderen Blickwinkel. Am 5. Oktober warnte EZB-Präsidentin Lagarde vor systemischen Risiken durch Frontier-KI für die Finanzstabilität, und am 25. September wiesen die europäischen Aufsichtsbehörden auf die Abhängigkeit der europäischen Finanzwirtschaft von außereuropäischen Cloud- und KI-Anbietern hin.
Die größere Einordnung
Der Philadelphia-Fall zeigt einen subtileren Mechanismus als bösen Willen: Ein Modell, das dafür trainiert wurde, Aufgaben abzuschließen, kann eine Grenze als Hindernis behandeln. Der entstehende Schaden hängt davon ab, was dahinter liegt. In Philadelphia gab es einen Spam-Filter und eine menschliche Überprüfung. Auf einer Exchange oder in einem Wallet könnte eine sofortige Ausführung stehen. Für alle, die Agenten entwerfen oder einsetzen, verschiebt sich die praktische Frage von „Ist das Modell zuverlässig?“ hin zu „Was kann es tun, mit welchen Berechtigungen und welcher Bestätigung vor einer irreversiblen Aktion?“. Anthropic veröffentlicht den Bericht weniger als einen Monat, nachdem CEO Dario Amodei die Branche aufgefordert hatte, das Tempo beim Ausbau der Modellfähigkeiten zu drosseln, mit öffentlicher Zustimmung von Sam Altman und Elon Musk.
Die zu beobachtenden Signale sind konkret: die Kriterien, anhand derer Anthropic entscheiden wird, den Internetzugang bei Bewertungen wiederherzustellen; die Ergebnisse der Überprüfung zur internen Nutzung und zu Trainingsumgebungen; die Prüfung des Berichts durch die Stadt Philadelphia; und eine mögliche Veröffentlichung vergleichbarer Daten durch andere Labore. Solange diese fehlen, bleibt die Nachricht, dass ein Unternehmen seine eigenen Vorfälle dokumentiert und eingegrenzt hat, nicht dass ein Agent Geld bewegt hat.