Ein Netzwerkfehler hat den Zugang zu Outlook, Teams, Copilot und weiteren Microsoft-365-Funktionen für Nutzer in zahlreichen Ländern über einen Tag lang unterbrochen. Microsoft teilte mit, das Problem sei nach einer Netzwerkkonfiguration aufgetreten, und meldete Fortschritte bei der Wiederherstellung. Noch am 14. November wies die öffentliche Statusseite auf eine anhaltende Dienstverschlechterung hin. Laut eigenen Angaben schließt Microsoft einen Cyberangriff sowie einen Zusammenhang mit KI-Systemen aus; die vollständige technische Ursache soll ein nachgelagerter Vorfallbericht liefern.
Für diesen Artikel wurden die öffentliche Microsoft-Statusseite, Meldungen der Associated Press sowie ein Bericht von Sky News herangezogen. AP berichtet, dass die Meldungen auf Downdetector in 74 Ländern weit über dem Durchschnitt lagen; es handelt sich dabei um Nutzermeldungen, nicht um eine offizielle Zahl betroffener Personen.
Der Ausfall betraf Mail, Zusammenarbeit und Copilot
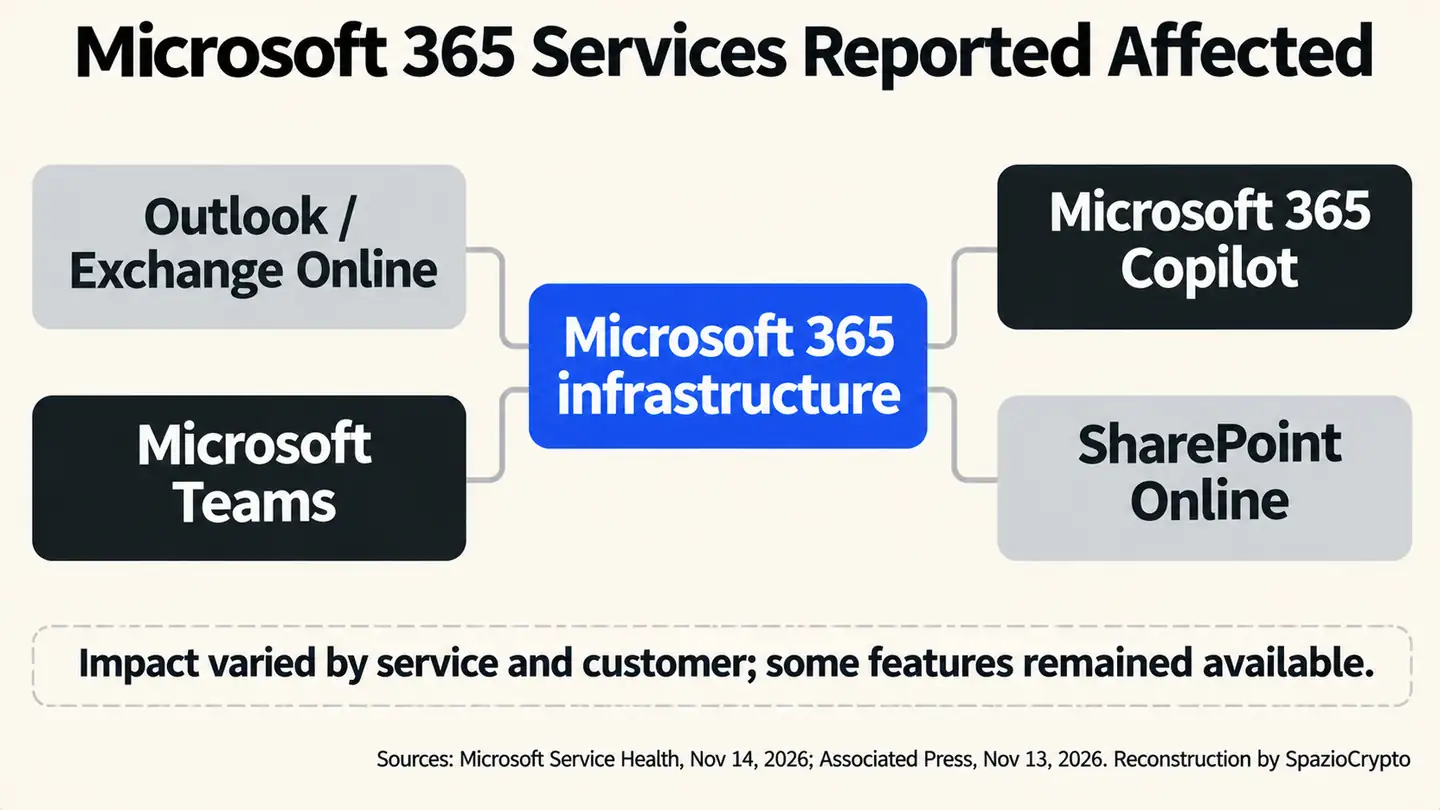
Der Vorfall begann am 12. November und erfasste mehrere Komponenten von Microsoft 365. Zu den betroffenen Diensten zählten laut Statusmeldungen Exchange Online und Outlook, Teams, Copilot, SharePoint sowie einzelne Verwaltungs- und Produktivitätsfunktionen. Die Auswirkungen waren je nach Produkt unterschiedlich: Microsoft gab an, dass von Exchange und dem Mailsystem abhängige Funktionen eingeschränkt waren, während nicht daran gekoppelte Dienste weiterhin verfügbar blieben.
Nutzer berichteten von Problemen beim Öffnen des Postfachs, Verzögerungen bei der E-Mail-Zustellung und Ausfällen bestimmter Kollaborations- und KI-Assistenzfunktionen. Die Statusseite wies darauf hin, dass manche Kunden weiterhin mit zeitweiligen Zugriffsproblemen oder verzögerten Nachrichten rechnen mussten, während die Wiederherstellungsarbeiten liefen.
Die Ausbreitung auf verschiedene Produkte ist das auffälligste Merkmal dieses Vorfalls. Ein Cloud-Dienst besteht nicht aus unabhängigen Einzelanwendungen: Authentifizierung, Netzwerk, Mail, Speicher und Backend-Dienste unterstützen häufig mehrere Tools gleichzeitig. Wenn eine gemeinsam genutzte Schicht ausfällt oder nicht mehr korrekt antwortet, können Auswirkungen bei Produkten sichtbar werden, die Nutzern voneinander getrennt erscheinen.
Das bedeutet nicht, dass alle Microsoft-Dienste ausgefallen wären oder Azure einen generellen Ausfall erlitten hätte. Die dokumentierte Störung betraf spezifische Microsoft-365-Funktionen mit unterschiedlichen Auswirkungen je nach Region und Produkt. Die Abhängigkeit ganzer Organisationen von wenigen Cloud-Plattformen wird durch solche Vorfälle sichtbar.
Microsoft führt den Ausfall auf eine Netzwerkkonfiguration zurück
Im Update vom 13. November beschrieb Microsoft den Vorfall als technisches Problem ohne Bezug zu einem Cyberangriff oder zu KI-Systemen. Die Gesellschaft erklärte, ein früheres Kapazitäts-Upgrade des Netzwerks habe sich nach einer nachfolgenden Änderung negativ ausgewirkt. Ingenieure arbeiteten daran, Kapazitäten zurückzugewinnen, betroffene Systeme wiederherzustellen und die Dienste schrittweise auf stabile Niveaus zurückzuführen.
Die öffentliche Formulierung klärt die Art des Ereignisses, ersetzt aber keine vollständige technische Ursachenanalyse. Microsoft kündigte an, nach der Problembehebung einen Vorfallbericht mit Hauptursache und Präventionsmaßnahmen zu veröffentlichen. Bis dahin sollten spezifischere Angaben zu Konfigurationen, betroffenen Komponenten und der Fehlersequenz nicht als gesichert dargestellt werden.
Auch der Ausschluss eines Cyberangriffs ist der Unternehmensaussage zuzuordnen. Microsoft erklärte, keine Hinweise auf böswillige Aktivitäten im Zusammenhang mit dem Problem gefunden zu haben. Das ist eine hilfreiche Information, ersetzt aber weder den abschließenden Bericht noch eine unabhängige Überprüfung. Frühe Spekulationen im Internet sind keine Belege für die Ursache des Ausfalls.
Die Unterscheidung zwischen einem technischen Problem und einem Sicherheitsvorfall ist für Unternehmen und Behörden wesentlich. Im ersten Fall liegt das Hauptrisiko in der Verfügbarkeit; im zweiten können unbefugter Zugriff oder Datenverlust hinzukommen. Nach aktuellem Stand weisen die öffentlichen Informationen von Microsoft auf ein Verfügbarkeits- und Kapazitätsproblem hin, nicht auf eine Datenkompromittierung.
Weitgehende Erholung, aber der Vorfall ist noch nicht geschlossen
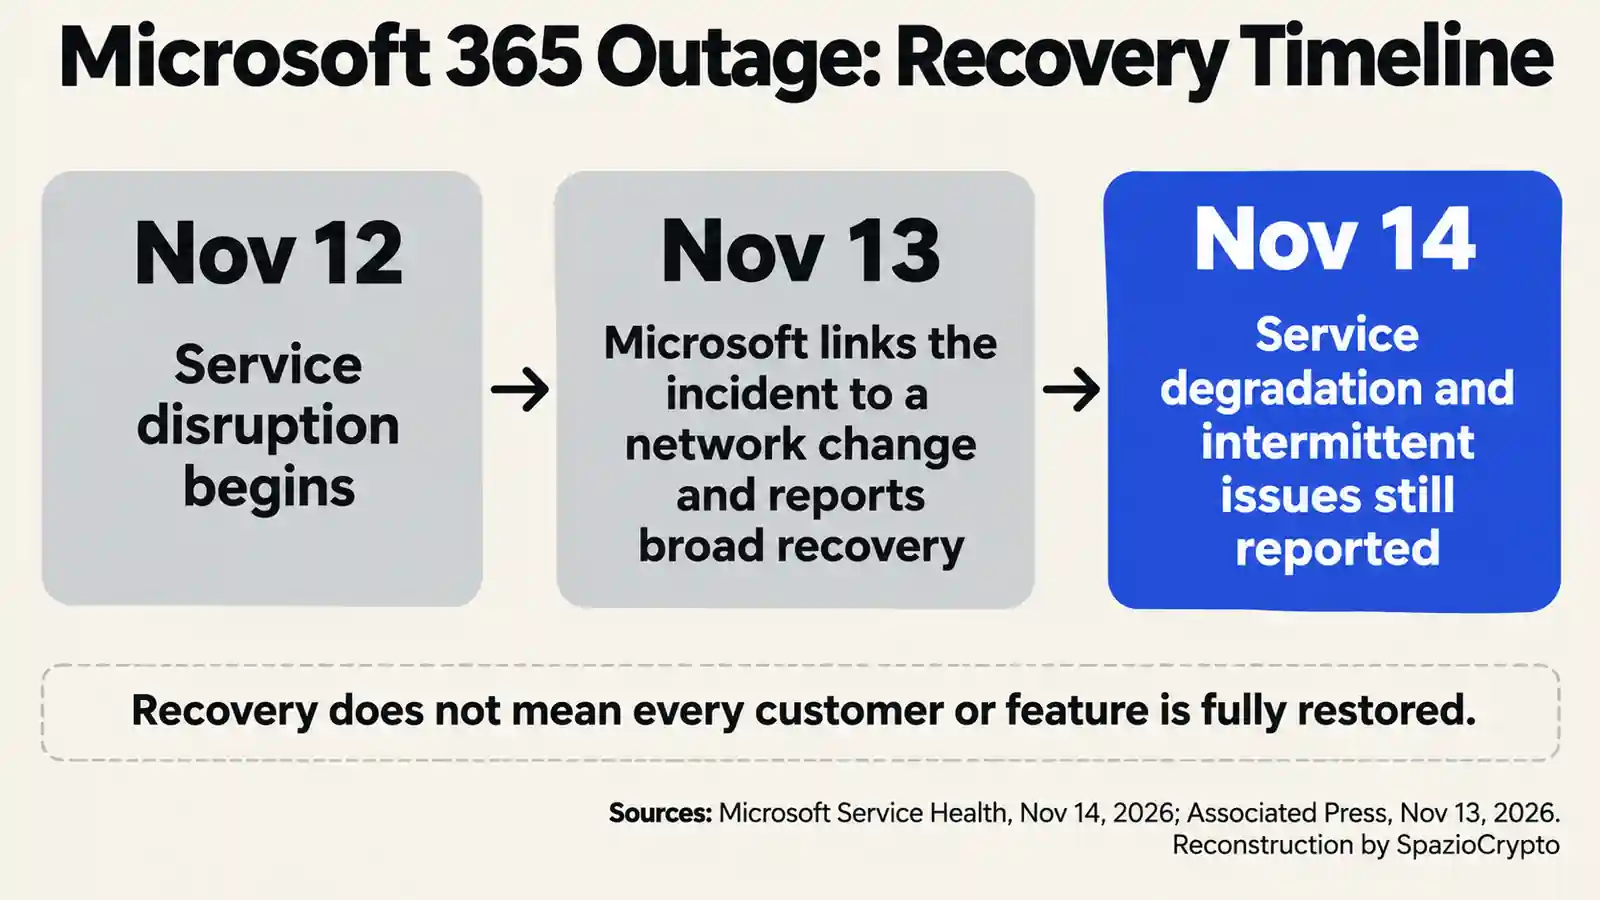
AP berichtete am 13. November, Microsoft beobachte eine ausgedehnte Erholung und zunehmende Stabilität in Nordamerika, Europa und dem asiatisch-pazifischen Raum. Die E-Mail-Warteschlangen näherten sich wieder normalen Werten, doch einzelne Kunden mussten weiterhin mit zeitweiligen Zugriffsproblemen und Verzögerungen rechnen. Am 14. November wies die öffentliche Statusseite noch immer auf eine Dienstverschlechterung bei Microsoft 365 hin: Die Erholung ist daher nicht mit dem formalen Abschluss des Vorfalls gleichzusetzen.
Die betrieblichen Folgen gingen über individuelle Unannehmlichkeiten hinaus. AP sammelte Berichte über Ausfälle bei Unternehmen und Behörden in mehreren Ländern, darunter Einrichtungen, die für Kommunikation und interne Abläufe auf E-Mail angewiesen sind. Die Auswirkungen variierten von Organisation zu Organisation: Nicht alle Funktionen standen still, und nicht jede genannte Stelle meldete einen kritischen Ausfall.
Microsoft 365 zählt laut AP über 450 Millionen kostenpflichtige Unternehmensabonnements. Die Zahl verdeutlicht die potenzielle Reichweite eines Plattformausfalls, gibt aber keinen Aufschluss darüber, wie viele Nutzer diesmal tatsächlich betroffen waren. Das Unternehmen hat keine geprüfte Gesamtzahl betroffener Konten veröffentlicht.
Der Vorfall rückt die Abhängigkeit von wenigen Cloud- und Produktivitätsanbietern wieder in den Mittelpunkt. Europäische Behörden haben bereits auf die Risiken hingewiesen, die mit der Konzentration digitaler Dienste und KI-Ressourcen bei Anbietern außerhalb der EU verbunden sind. Dieser Vorfall allein belegt kein systemisches Risiko, zeigt aber, warum Kontinuitätspläne und alternative Systeme einer praktischen Überprüfung bedürfen.
Resilienz erfordert auch Kontinuitätspläne
Eine Organisation kann Ausfälle bei externen Anbietern nicht vollständig verhindern, wohl aber deren betriebliche Auswirkungen begrenzen. Zu den zu prüfenden Maßnahmen zählen alternative Kommunikationswege für dringende Nachrichten, lokal gespeicherte Kopien wichtiger Kontakte, unabhängige Datensicherung und -archivierung, Notfallrollen sowie Verfahren, um nach Rückkehr der Plattform rasch wieder arbeitsfähig zu sein. Ein schriftlicher Plan genügt nicht: Er muss auch ohne die möglicherweise ausgefallenen Dienste getestet werden.
Das Thema berührt auch die physische Struktur der digitalen Wirtschaft. Die Erweiterung der Rechenzentren von Microsoft und anderen Hyperscalern wird häufig in den Kategorien Energie und Rechenkapazität diskutiert; Zuverlässigkeit, Redundanz und Vernetzung sind ein weiterer Teil derselben Infrastruktur. Je mehr Dienste auf gemeinsam genutzte Plattformen aufsetzen, desto wichtiger wird es zu verstehen, welche Abhängigkeiten geteilt werden und welche Alternativen wirklich unabhängig sind.
Das Wachstum von Cloud-Diensten macht außerdem die Fähigkeit strategisch bedeutsam, Lasten und Daten auf mehrere Infrastrukturen zu verteilen. Kapazität, Energie und geografische Lage werden zu wesentlichen Bausteinen digitaler Dienste. Redundanz entsteht nicht allein durch den Kauf zusätzlicher Server: Ausschlaggebend sind auch die Trennung der Systeme und die reale Möglichkeit, zu einem anderen Anbieter zu wechseln.
Der Vergleich mit Multi-Cloud-Vereinbarungen ist dennoch mit Bedacht anzustellen. Ein zweiter Anbieter garantiert keine Kontinuität, wenn Identität, Mail, Backups oder interne Prozesse weiterhin am selben Fehlerpunkt hängen. Auch der Zugang zu Modellen und Diensten aus verschiedenen Clouds entspricht nicht automatisch einer Disaster-Recovery-Strategie: Dafür sind spezifische Architekturen und Tests erforderlich.
Microsoft 365 im Überblick
Microsoft 365 im Überblick
Was bestätigt ist, was nicht
- Bestätigt: Microsoft meldete einen Vorfall, der mehrere Microsoft-365-Dienste betraf, und kommunizierte Fortschritte bei der Wiederherstellung.
- Nicht angegeben: die verifizierte Zahl der betroffenen Nutzer sowie die vollständige Grundursache, die Microsoft laut eigener Aussage nach Abschluss der Mitigierung dokumentieren will.
- Weiter beobachten: die offizielle Schließung des Vorfalls, der Post-Incident-Bericht und die stabile Wiederherstellung von E-Mail und verbundenen Funktionen.
Die größere Einordnung
Als redaktionelle Interpretation lässt sich festhalten: Der Vorfall macht die Betriebskosten der Konzentration sichtbar. Eine einzige Netzwerkänderung kann mehrere Dienste beeinträchtigen, sobald diese gemeinsame Komponenten und Infrastrukturen teilen. Das ist kein Beleg dafür, dass Cloud-Dienste grundsätzlich unzuverlässig sind, und es beweist auch nicht, dass Microsofts Redundanzmaßnahmen unzureichend waren. Für eine fundierte Beurteilung der Ursachen und Gegenmaßnahmen ist der technische Abschlussbericht abzuwarten.
Die nächsten relevanten Signale sind die offizielle Schließung des Vorfalls, die detaillierte Erklärung der technischen Abfolge und die von Microsoft angekündigten Präventionsmaßnahmen. Für Unternehmenskunden ist der praktischste Test, zu prüfen, ob Notfallprozeduren greifen, wenn E-Mail, Zusammenarbeit und Dateizugang gleichzeitig von einem einzigen Ökosystem abhängen.
Quellen
Konkret: dienststatus und Wiederherstellungsupdates: Microsoft Service Health, abgerufen am 14. November 2026. Internationale Reichweite, Wiederaufnahme und Dienstabhängigkeiten: Associated Press, 13. November 2026. Microsoft-Aussagen zur technischen Ursache und zur Wiederherstellung: Sky News, 13. November 2026.