Kann ein Anbieter beweisen, dass er wirklich das versprochene KI-Modell einsetzt? Am 2. November veröffentlichte Anthropic FlashProve, einen quelloffenen Prototyp, der einen kryptografischen Beweis erzeugt und damit nachweist, dass eine Antwort von einem bestimmten Modell stammt, ohne dessen Gewichte offenzulegen. Die Demonstration betrifft Llama 4 Maverick in einer 4-Bit-Version, bei Fenstern von 1.024 Token. FlashProve ist kein aktiver Dienst auf den Claude-APIs, und der Code ist ausdrücklich als nicht gepflegt deklariert.
Dieser Bericht basiert auf dem Forschungsbeitrag von Anthropic, der von unternehmensinternen Forschern zusammen mit Akademikern der EPFL und des MIT verfasst wurde, sowie auf dem README des öffentlichen GitHub-Repositorys. Der X-Post, mit dem Anthropic die Arbeit am 3. November ankündigte, ließ sich mit unseren Werkzeugen nicht öffnen. Die zitierten Leistungsdaten sind Angaben von Anthropic und wurden nicht von Dritten gemessen.
New Anthropic research: progress on provable inference for large language models.
, Anthropic (@AnthropicAI) November 3, 2026
Here, we introduce FlashProve. Building on established cryptographic techniques, FlashProve allows developers to verify whether a given response came from a given AI model. It's substantially more…
Das Problem: Welches Modell hat wirklich geantwortet?
Laut Anthropic können Nutzer heute nicht überprüfen, ob Antworten tatsächlich von dem Modell stammen, das ein Entwickler angibt. Der Forschungsbeitrag benennt zwei konkrete Risiken. Erstens gibt es Routing-Dienste, die das versprochene Modell durch ein günstigeres ersetzen könnten. Zweitens existieren Angriffe, die den Token-Fluss zwischen Modell und Nutzer manipulieren. Für Unternehmen, die KI-Dienste über Zwischenplattformen einkaufen, ist das ein reales Problem: Sie zahlen für ein bestimmtes Modell, haben aber keine Möglichkeit zu kontrollieren, welches tatsächlich arbeitet.
Das Thema gewinnt an Brisanz, weil die Vertriebskanäle für KI-Modelle immer zahlreicher werden: von Cloud-Plattformen, die Modelle Dritter weiterverkaufen, bis hin zu Open-Weight-Modellen, die mehrere Anbieter zu unterschiedlichen Preisen anbieten.
Wie es funktioniert: Commit, Beweis, Verifizierung
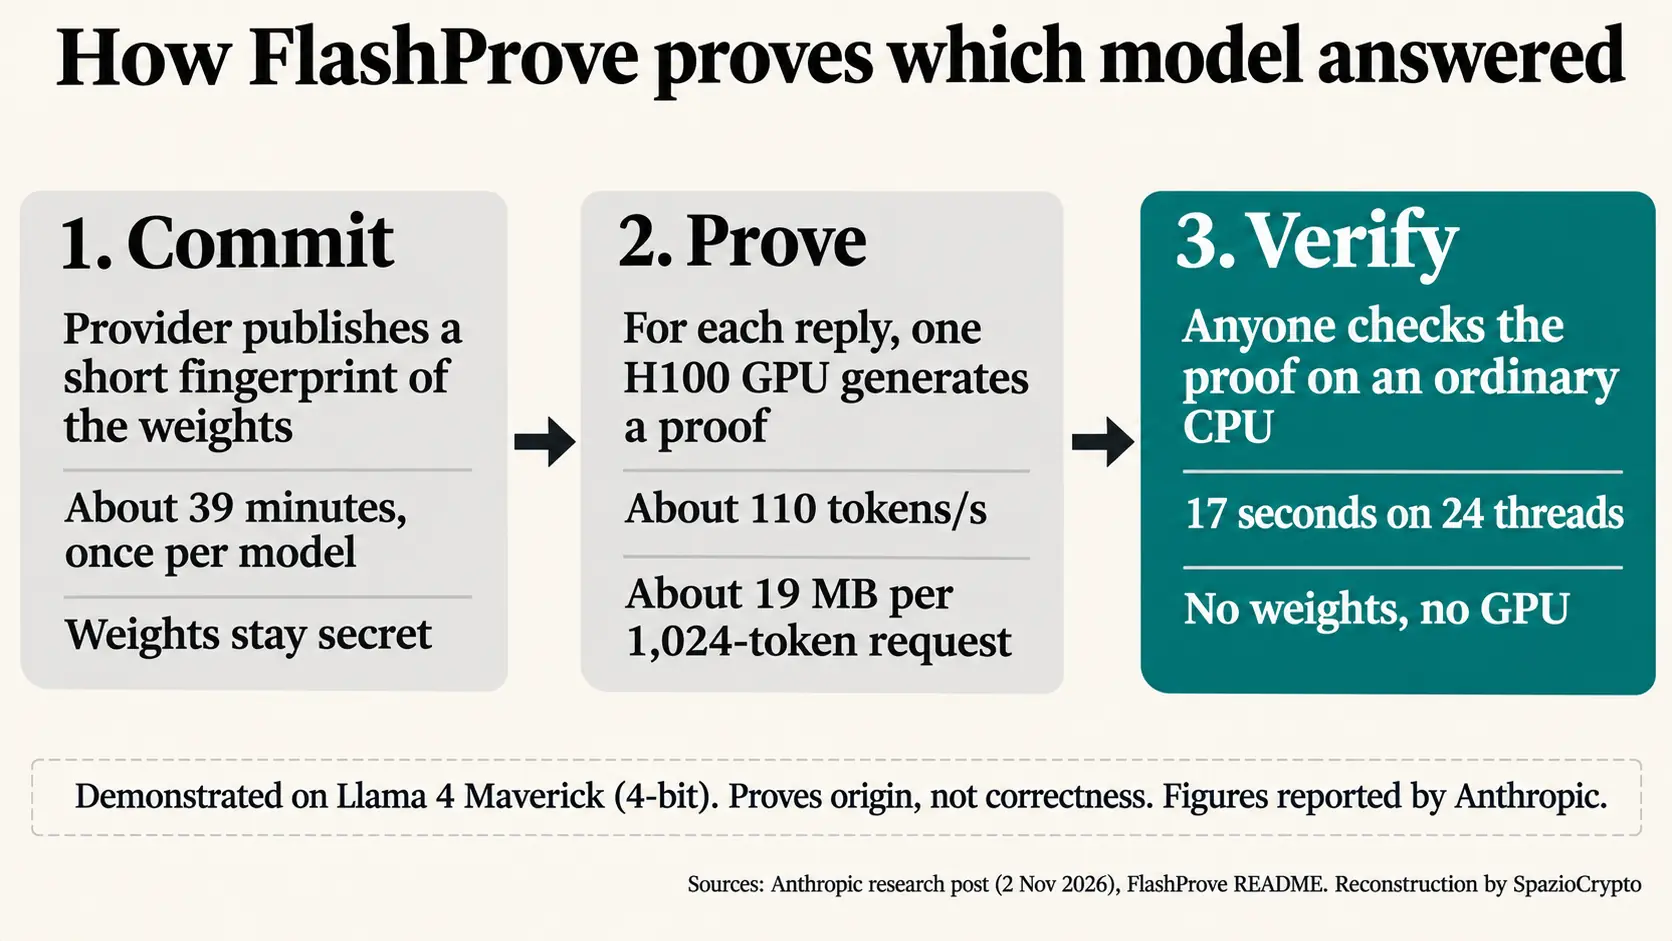
Das System arbeitet in drei Schritten. Zunächst veröffentlicht der Anbieter einen kurzen Fingerabdruck, der ihn auf einen genauen Satz von Gewichten festlegt, ohne diese preiszugeben. Laut Anthropic dauert dieser Schritt einmalig pro Modell rund 39 Minuten. Dann erzeugt die GPU des Anbieters für jede Antwort einen Beweis, dass die Token-Sequenz tatsächlich dem Ausgabe des gebundenen Modells entspricht. Schließlich kann jedermann den Beweis auf einem normalen Prozessor überprüfen, ohne Gewichte und ohne GPU, allein mit dem Fingerabdruck, dem Prompt und der Antwort.
Die eingesetzte Technik ist ein zkSNARK, ein Zero-Knowledge-Beweis: Er belegt, dass eine Berechnung korrekt durchgeführt wurde, ohne die verwendeten Daten offenzulegen. Es handelt sich um dieselbe Werkzeugfamilie, die in der Krypto-Welt für Datenschutz und Skalierbarkeit genutzt wird und die auch die Banca d'Italia untersucht hat, um Datenschutz und Kontrollen im digitalen Zahlungsverkehr zu verbinden. Verborgen bleiben die Gewichte, die Zwischenwerte und die Routing-Entscheidungen der Modell-Experten. Die Architektur selbst, betont Anthropic, wird nicht versteckt.
Die Kennzahlen des Prototyps
Llama 4 Maverick ist ein Modell mit 400 Milliarden Parametern und einer Mixture-of-Experts-Architektur, von denen laut Anthropic rund 17 Milliarden pro Token aktiv sind. Der Prototyp arbeitet mit einer öffentlichen 4-Bit-Konvertierung. Auf einer einzelnen H100-GPU mit 24 Prozessorkernen läuft die Beweisphase laut Anthropic mit etwa 110 Token pro Sekunde; jede Anfrage mit 1.024 Token erzeugt Beweise von rund 19 Megabyte. Die Verifikation eines Beweises dauert 17 Sekunden bei 24 Threads, und der Client muss etwa 6,5 Megabyte Commit-Daten herunterladen.
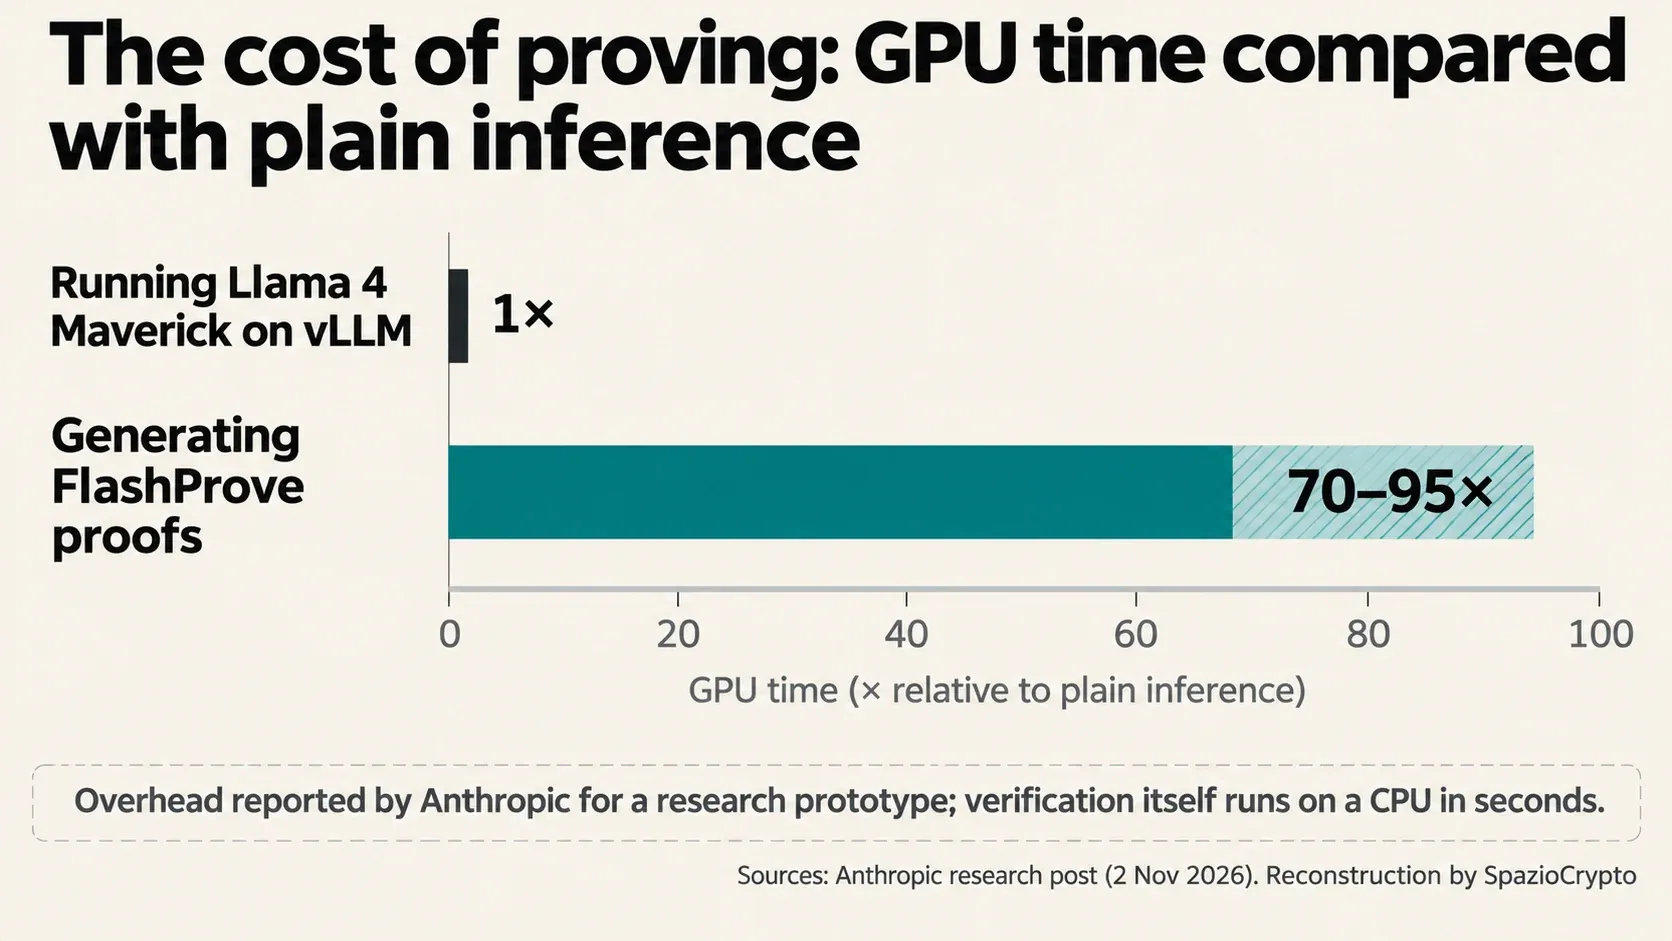
Der entscheidende Kostenfaktor: Laut dem Forschungsbeitrag von Anthropic erfordert die Beweisgenerierung zwischen 70 und 95 Mal so viel GPU-Zeit wie das reine Ausführen des Modells mit vLLM, einer der meistgenutzten Inferenz-Engines. Anthropic vergleicht das Ergebnis mit der Arbeit von Attestable, die auf einem dichten Modell mit 31 Milliarden Parametern 53 bis 77 Token pro Sekunde erreicht, aber keine Open-Source-Bibliothek veröffentlicht hat.
Was der Beweis nicht garantiert
Der Beweis sagt aus, von welchem Modell eine Antwort stammt, nicht ob die Antwort inhaltlich korrekt ist. Anthropic nennt weitere Einschränkungen. Der Beweis betrifft deterministische Dekodierung: Bei Sampling, das Zufälligkeit in die Antworten einbringt, könnte die tatsächliche Ausgabe ab einem bestimmten Punkt abweichen. Das bewiesene Modell ist eine exakte Vollversion der Gewichte, und eine in Gleitkomma berechnete Antwort könnte davon abweichen. Quasi-Äquivalenz deckt keine Prompts ab, die gezielt darauf ausgelegt sind, diese Unterschiede auszunutzen, und zeitbasierte Angriffe liegen außerhalb des Schutzbereichs.
Dazu kommen praktische Grenzen. Das 1.024-Token-Fenster ist nach den eigenen Worten von Anthropic „ziemlich kurz“ für ein Gespräch. Der schnelle C++-Code hat keine formalen Garantien und es ist nicht sichergestellt, dass er exakt der in der Lean-Sprache geschriebenen Beweis-Spezifikation entspricht, in der die Protokollsicherheit mathematisch nachgewiesen ist. Das README des Repositorys ist eindeutig: Es handelt sich um ein Forschungsartefakt, das „nicht gepflegt“ wird und keine Beiträge akzeptiert. Externe Sicherheitsaudits sind nicht vermerkt.
 Anthropic
Und in Deutschland?
Konkret: für deutsche Unternehmen und Behörden, die KI-Dienste über Reseller oder Plattformen beziehen, ändert FlashProve heute noch nichts: Es ist kein Produkt und in keine kommerziellen Dienste integriert. Dennoch zeigt es eine Richtung. Ein Vertrag, der ein bestimmtes Modell verspricht, könnte künftig durch einen kryptografischen Beweis verifizierbar sein, statt allein auf das Vertrauen gegenüber dem Anbieter zu setzen. Denselben Schritt haben Zero-Knowledge-Beweise im Finanzbereich vollzogen, wo Coinbase deren Anerkennung in den US-amerikanischen Geldwäschevorschriften beantragt.
 Steve Weis
Das Thema berührt auch die technologische Abhängigkeit Europas. Aufsichtsbehörden haben darauf hingewiesen, dass der EU-Finanzsektor auf ausländische KI-Systeme angewiesen ist, die oft über mehrere Anbieterebenen erreicht werden. Anbieterunabhängige Prüfwerkzeuge könnten bei sinkenden Kosten zu einer Vertragsanforderung werden. Bei einem aktuellen Rechenaufwand von 70 bis 95-fachem Overhead, laut Anthropic-Veröffentlichung vom 2. November, ist das für den täglichen Einsatz noch keine realistische Option.
FlashProve im Überblick
Was bestätigt ist, was nicht
- Bestätigt: Open-Source-Prototyp unter Apache-2.0-Lizenz, veröffentlicht am 2. November; demonstriert auf Llama 4 Maverick mit 4-Bit-Quantisierung und 1.024-Token-Fenstern; CPU-Verifikation in 17 Sekunden ohne Modellgewichte; Rechenaufwand 70 bis 95-fach gegenüber normaler GPU-Inferenz; Code ausdrücklich als nicht gepflegt deklariert.
- Nicht angegeben: externe Sicherheitsaudits; Kosten in Geldeinheiten; Anwendung auf Claude-APIs oder andere Modelle; Laufzeiten bei längeren Kontexten.
- Zu beobachten: Erweiterung auf längere Kontexte und andere Architekturen; mögliche Übernahme durch Anbieter oder Plattformen; unabhängige Code-Prüfungen.
Das größere Bild
Unsere Einschätzung, die wir als solche kennzeichnen: FlashProve überträgt eine Idee aus der Krypto-Welt in den KI-Bereich, nämlich nicht zu vertrauen, sondern zu verifizieren. Heute muss ein Nutzer eines KI-Dienstes dem Anbieter glauben, welches Modell tatsächlich läuft, so wie man früher einem Intermediär beim Kontostand vertrauen musste. Der kryptografische Beweis trennt zwei Fragen, die häufig vermischt werden: die Herkunft einer Antwort und ihre Qualität. FlashProve beantwortet nur die erste Frage. Das ist bereits beachtlich. Ob Anthropic oder andere diesen Ansatz in reale Dienste überführen, ähnlich wie bei anderen Transparenzinitiativen etwa dem internen Zugang der METR-Evaluatoren bei Anthropic, bleibt abzuwarten.
Drei Entwicklungen verdienen besondere Aufmerksamkeit. Erstens die Reduktion des Rechenaufwands, der laut Anthropic derzeit zwischen dem 70- und 95-Fachen liegt, ohne die kein Anbieter Beweise für jede Antwort liefern kann. Zweitens die Ausweitung auf lange Kontexte und weitere Modelle, einschließlich solcher mit geschlossenen Gewichten wie Claude. Drittens die Frage, ob der von den Autoren aufgegebene Code von anderen Gruppen oder Plattformen weiterentwickelt wird, die eine nachweisbare Modellherkunft als Verkaufsargument nutzen wollen.